简短的答案
结果更容易阅读。改过的值、新增的键、删除的条目会更清楚。原本淹没普通差异比较的格式变化和键顺序变化被消除,因为比较前两份内容采用了相同的写法。
两个页面都没有任何网络功能——这一点值得知道:人们拿来比对的 JSON,太多时候是凭据还躺在里面的配置文件。
配置改动和 API 回归检查
比较预发布与生产配置时保留原件,把副本都设为两空格缩进并排序对象键。预发布放左、生产放右,不勾选忽略大小写或空白,检查端点、功能开关和上限。字符串里的空格、键的大小写可能有意义。确认两侧环境再下载补丁。
比较 API 改动前后响应也一样,使用相同请求输入,另行考虑时间戳和生成 ID。数组顺序保留,重新排序仍会显示差异。1 与 1.0、转义写法不同的字符串也可能不同。这里比较格式化后的文字,不检查架构,也不判断所有 JSON 值是否等价。JSON 标准把对象定义为无序,把数组定义为有序。
为什么生比 JSON 几乎全是噪音
JSON 不在乎空白,也不给键的顺序赋予意义。同一份文档可以是一行,也可以是四百行;键可以按敲下的顺序排,也可以按某个库吐出的顺序排——工具改写这两样从不打招呼。一边压缩了,一边铺开了;一边手工存的,一边出自按字母排序的序列化器:逐行比对看见的是两个不相干的文件。
两个最糟的情形足以说明问题。压缩过的文件是一行,于是和它比对得到一条巨大无比的变更行——正确,且无用。而内容相同、顺序不同的两个文件会比出个处处皆变,诚实的答案本该是“什么都没变”。
格式化器的规范形修好了什么
两个文件过同一个格式化器、用同样的设置,正是比对需要的:一份文档一种拼法。
- 同样的缩进让每个键各占一行:比对于是逐行工作,它的逐词标记也能指着一行里唯一变了的那个值。
- 排好序的键让两边同序,顺序就不再是差异。排序按键读起来的样子,不按码位——
item2排在item10前——并且两边施加得一模一样。 - 其余分毫不动。这个格式化器让数字保持你写下的每一位,保留重复的键而不是替你裁决:规范化自己变不出差异来。格式化器指南解释了这为什么比理应的更稀罕。
一句诚实的但书:排序后的输出是键挪了位的文档。要是下游某个工具在乎键的顺序——在乎的不多,但存在——就把排序的副本当作被比对的东西,而不是原件的替身。
读结果,并带走它
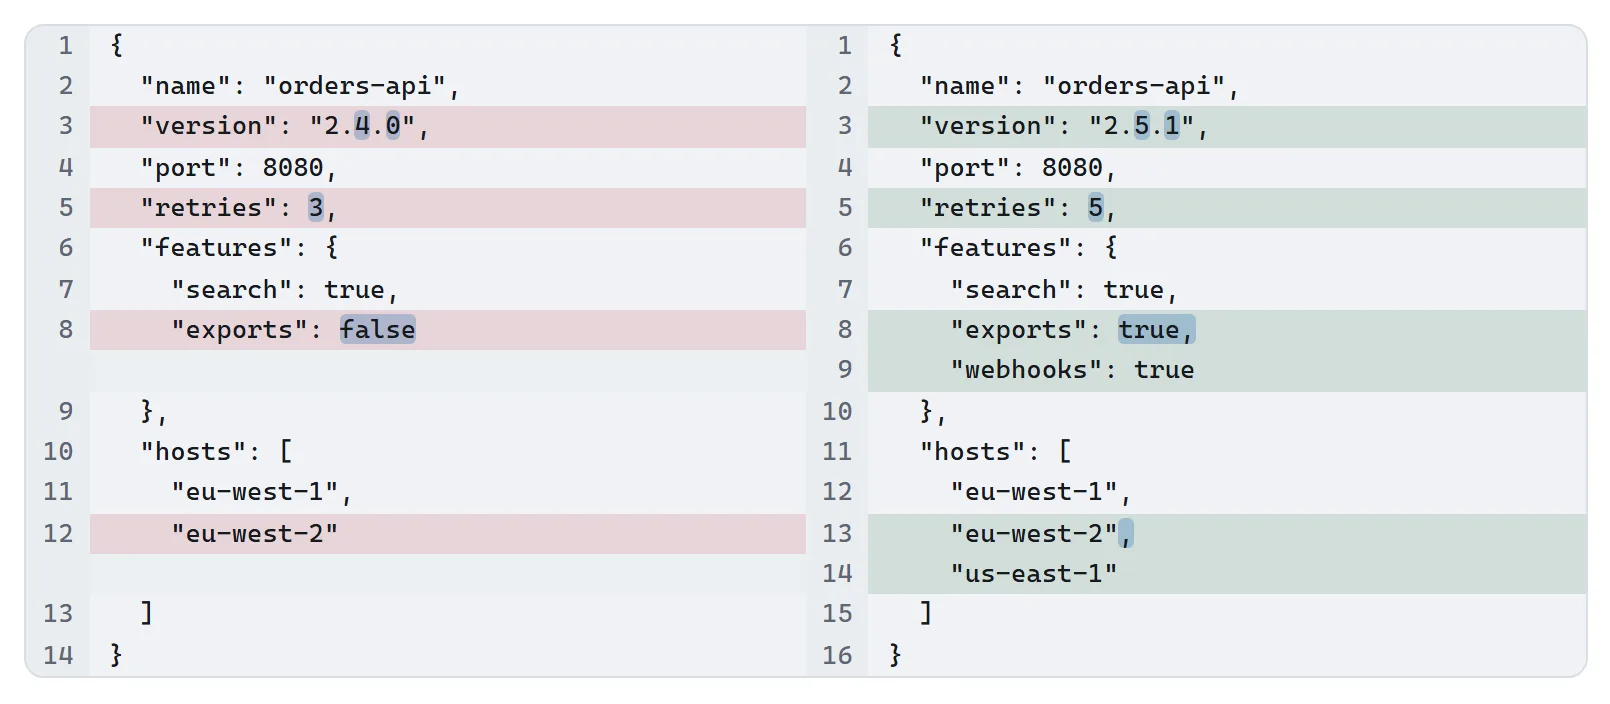
比对把删掉的行标在左边、新增的行标在右边,变了的行里再把不同的词高亮出来:在规范形上,那通常就是从 false 挪到 true 的那一个值。没变的中段折叠成一个数字,两千行的配置改了三处,读起来就是三小段。
下载下来的是统一格式的补丁,一个 .patch——代码评审看得懂的格式。它描述的是规范形,而那通常正是评审想要的:只有改动,没有重排。
先格式化再比较,也能让 YAML 或 XML 更容易审查,但它们的空白和转换规则不同于 JSON。如果只需要调整排版,就保留原语言。比较工具的忽略开关影响视图,补丁仍比较实际输入字符串。这里输入的是格式化后的副本,因此补丁不是针对未改动原件生成的。
如果你每周都做这件事
格式化两次、粘贴两次:步骤住在两个页面上,因为每页只干一件事,而且各自都能证明你贴的东西哪儿也没去。但两个都是开源的:MIT 许可证,零依赖的 ES 模块——格式化器的解析器保住键序和数位,比对是 Myers 算法——各配一份讲明白它的 README。
要是这已是你每天的一部分,把编码智能体指向代码仓库,请它做一页两个框、边比对边规范化的页面:parseJson、printJson 和 compareText 只隔三个 import。这些模块写出来就是给人读的,把它们搬走,正是这份许可证存在的目的。